GPT-6 Astra, Sol und Luna: Welches Modell passt zu welcher Aufgabe?
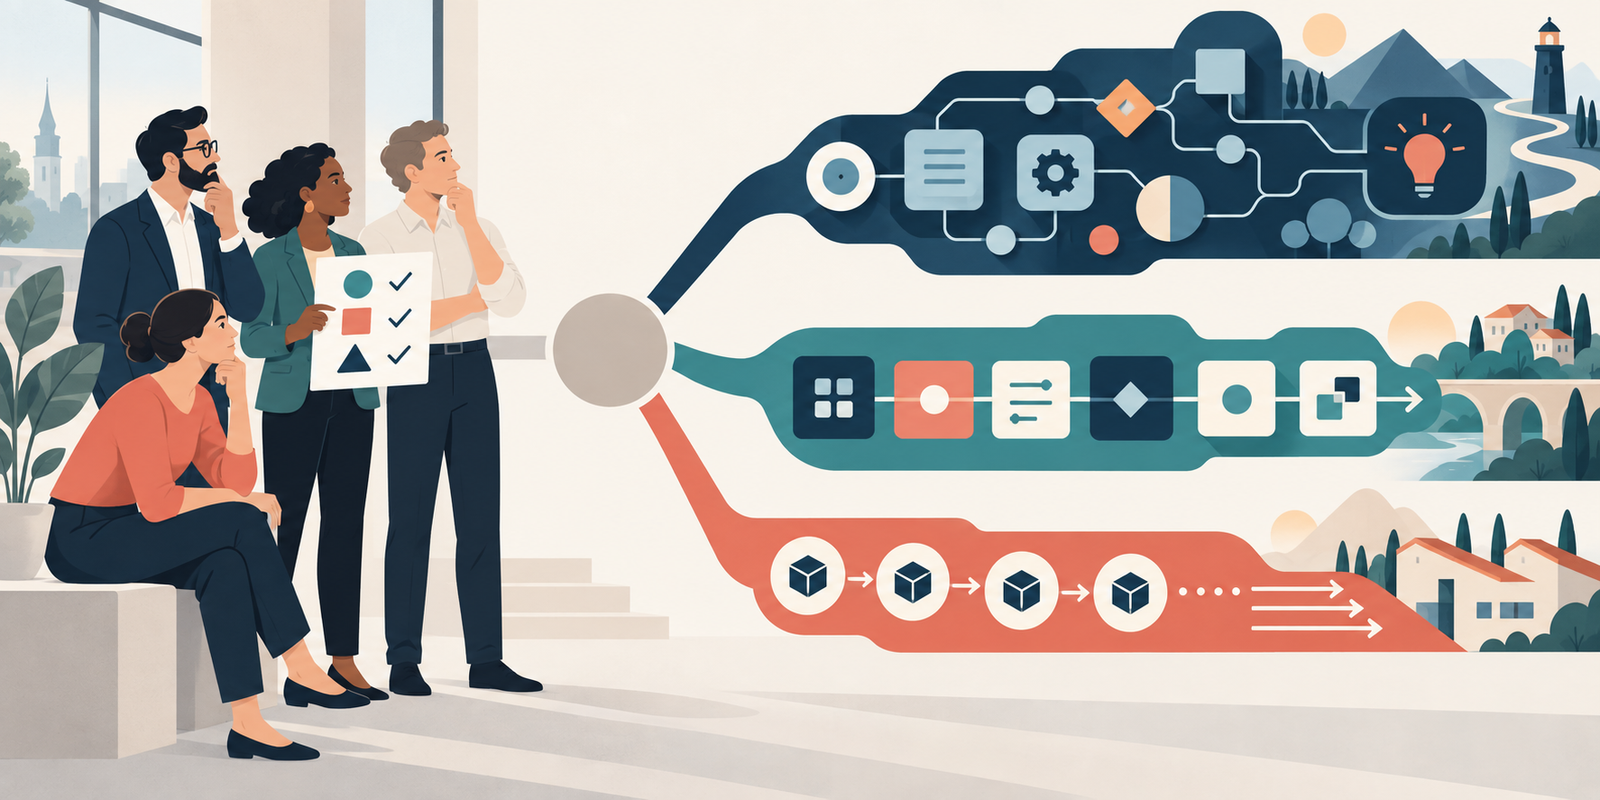
OpenAI hat seine GPT-6-Familie erweitert: Auf Astra, vorgestellt Anfang September, folgten am 22. September 2026 Sol und Luna. Für Unternehmen ist das keine Frage nach dem einen „besten“ Modell. Die nützlichere Frage lautet: Welche Aufgaben brauchen besonders hohe Leistungsfähigkeit, welche eine verlässliche Balance aus Leistung und Kosten und welche müssen in großer Zahl wirtschaftlich bearbeitet werden? OpenAI positioniert Astra, Sol und Luna genau entlang dieser Auswahl.
Was wurde tatsächlich neu angekündigt?
Die aktuelle Nachricht betrifft vor allem GPT-6 Sol und GPT-6 Luna. OpenAI hat beide am 22. September als Erweiterung der Familie vorgestellt. Astra war bereits am 3. September erschienen. Wer die drei Modelle in einem Atemzug „heute veröffentlicht“ nennt, vermischt zwei Termine. Die offizielle API-Chronik und die drei Modellseiten sind für diese Einordnung verlässlicher als weitergereichte Schlagzeilen.
Die Rollen beschreibt OpenAI deutlich: Astra soll besonders anspruchsvolle, mehrstufige Arbeiten abdecken, etwa Forschung, Programmierung und die Bedienung von Software. Sol ist auf komplexe Coding- und Agentenabläufe ausgelegt. Luna bezeichnet OpenAI als effizientes Modell für fokussierte Aufgaben mit hohem Volumen. Das ist eine Herstellerpositionierung, keine Garantie, dass ein Modell in Ihrem konkreten Prozess zuverlässig abschneidet.
Die Unterschiede auf einen Blick
| Modell | Geeigneter Startpunkt im Unternehmen | API-Standardpreis je 1 Mio. Text-Tokens |
|---|---|---|
| Astra | Schwierige, mehrstufige Aufgaben mit hoher Prüf- und Entscheidungsanforderung | 10 US-Dollar Input / 50 US-Dollar Output |
| Sol | Komplexere Programmierung und Agentenabläufe, bei denen Kosten mitentscheiden | 2 US-Dollar Input / 10 US-Dollar Output |
| Luna | Klar begrenzte, häufig wiederkehrende Arbeitsschritte | 0,10 US-Dollar Input / 0,50 US-Dollar Output |
Das sind API-Listenpreise für Text-Tokens aus den offiziellen Modellseiten, keine Kostenprognose für ein Projekt. Eingabemenge, Ausgabe, Caching, Verarbeitungstarif und Werkzeugaufrufe beeinflussen die Rechnung. Besonders bei sehr langen Anfragen gelten zusätzliche Tarifregeln. Aus den niedrigeren Listenpreisen von Sol und Luna folgt nicht automatisch, dass jeder Arbeitsablauf günstiger wird.
Großes Kontextfenster ist keine Qualitätszusage
Alle drei API-Modellseiten nennen ein Kontextfenster von 1,05 Millionen Tokens, maximal 922.000 Input-Tokens und 128.000 Output-Tokens. Die Zahlen sollte man nicht zu einer einzigen „Million Tokens Eingabe“ vereinfachen. Wichtiger für die Praxis: Ein langes Kontextfenster ersetzt weder die Auswahl relevanter Dokumente noch die Prüfung der Antwort. Wenn ein Agent in alten Richtlinien, aktuellen Vertragsständen und unsortierten Notizen zugleich sucht, kann eine falsche Quelle auch in einem großen Kontext überzeugend klingen.
Die Modellseiten nennen Text und Bilder als Eingabe, aber Text als Ausgabe. Dass über die Responses API Werkzeuge wie Websuche oder Bildgenerierung angebunden werden können, bedeutet nicht, dass die Modelle selbst native Audio-, Video- oder Bildausgabe liefern. Für konkrete Integrationen sollte das Team die unterstützten Schnittstellen und Werkzeugrechte prüfen, bevor es einen Prozess plant. Für Astra nennt OpenAIs Changelog die Responses API als Weg für Werkzeugaufrufe: Dass Chat Completions als Endpunkt unterstützt wird, bedeutet nicht, dass sich Astra-Werkzeuge darüber nutzen lassen.
Datenschutz und Verfügbarkeit vor dem Einkauf prüfen
Ein Modellvergleich ist erst brauchbar, wenn die technische Betriebsform zum Unternehmen passt. Die offiziellen Seiten für Sol und Luna nennen EU-Datenresidenz nur für die Standardverarbeitung; die Nutzung anderer Verarbeitungstarife kann diese Voraussetzung verändern. Prüfen Sie deshalb die aktuelle OpenAI-Liste für Datenresidenz, die vertraglichen Einstellungen und die konkrete API-Funktion, bevor personenbezogene oder vertrauliche Daten in einen Piloten gelangen. Eine bloße EU-Option auf der Modellseite ist keine Aussage darüber, dass Ihr bestehendes Konto bereits entsprechend konfiguriert ist.
Auch „verfügbar“ braucht einen genauen Bezug: Ein Modell kann in der API angeboten werden, während Berechtigungen, Tarife oder Oberflächen unterschiedlich ausgerollt werden. Testen Sie die Modellkennung und den benötigten Werkzeugaufruf in Ihrer tatsächlichen Umgebung. So vermeiden Sie, eine Architektur auf eine Funktion zu bauen, die für Ihr Konto oder Ihren Verarbeitungspfad noch nicht bereitsteht.
Wie trifft ein Mittelständler die Auswahl?
Beginnen Sie nicht mit einer Rangliste, sondern mit drei echten Aufgaben. Ein Beispiel: Ein Support-Team kategorisiert täglich Hunderte klar formulierte Anfragen. Ein Fachteam fasst technische Unterlagen zu einer Entscheidungsvorlage zusammen. Ein IT-Team lässt einen Agenten Änderungen an Software vorbereiten und testen. Für die erste Aufgabe könnte Luna ein wirtschaftlicher Ausgangspunkt sein, für die zweite Sol; bei besonders schwierigen mehrstufigen Arbeiten kann sich ein Test mit Astra lohnen. Das sind Pilothypothesen, keine pauschalen Eignungsurteile.
Für jeden Piloten braucht es denselben Datensatz und dieselben Messgrößen: fachliche Richtigkeit, Quellenbezug, Korrekturaufwand, Bearbeitungszeit und Gesamtkosten je erfolgreich erledigtem Fall. Messen Sie Fehlversuche und menschliche Nacharbeit mit. Ein günstiger Modellaufruf ist teuer, wenn Mitarbeitende seine Fehler regelmäßig beheben müssen. Umgekehrt muss die leistungsstärkste Variante nicht jeden einfachen Schritt ausführen. Unser Praxisleitfaden zur Modellauswahl zeigt, wie Fachbereiche solche Kriterien vor einem Piloten festlegen.
Agenten brauchen Grenzen, nicht nur ein leistungsfähiges Modell
Gerade bei Sol und Astra ist die Versuchung groß, den gesamten Arbeitsablauf an einen Agenten zu übergeben. Trennen Sie jedoch Recherche, Vorschlag, Prüfung und Ausführung. Ein Modell darf einen Blogentwurf oder eine Codeänderung vorbereiten; eine produktive Veröffentlichung oder ein Zugriff auf Kundendaten braucht zusätzlich eine eindeutige Berechtigung, technische Grenzen und einen überprüfbaren Rückweg. Ein zweites Modell kann Fakten und Stil kontrollieren, ersetzt aber keine überprüfbaren Quellen und keine Freigaberegel.
Für Software und laufende Automationen ist außerdem die Modellkennung wichtig: Wenn eine Anwendung ohne bewusste Prüfung auf eine neue Modellvariante wechselt, können Verhalten und Kosten anders ausfallen. Unser Beitrag zum Einsatz von OpenAIs „latest“-Modell in Produktion beschreibt, wie Teams Änderungen testen und einen Rollout absichern. Die neue Familie ist ein guter Anlass, diese Regeln auf bestehende Agenten zu übertragen.
Eine kurze Entscheidungshilfe für die nächste Woche
- Aufgabe begrenzen: Einen wiederkehrenden Vorgang mit messbarem Ergebnis auswählen, nicht sofort die gesamte Abteilung automatisieren.
- Gleiche Fälle testen: Luna, Sol und gegebenenfalls Astra mit denselben realistischen, datenschutzgerecht vorbereiteten Beispielen vergleichen.
- Fehlerkosten erfassen: Nacharbeit, falsche Aussagen und Eskalationen zählen, nicht nur Tokenpreise.
- Zugriffe begrenzen: Schreibende Werkzeuge und Veröffentlichungen erst nach Prüfung des konkreten Ergebnisses erlauben.
- Entscheidung dokumentieren: Festhalten, welches Modell für welchen Schritt eingesetzt wird und wann erneut geprüft wird.
OpenAIs neue Modelle erweitern damit die Auswahl, sie nehmen Unternehmen die Auswahlentscheidung nicht ab. Die beste Kombination hängt von Aufgabe, Risiko, Daten und Prüfbarkeit ab. Wenn Sie einen konkreten Anwendungsfall statt einer allgemeinen Modellrangliste bewerten möchten, ist eine strukturierte KI-Beratung der sinnvollere nächste Schritt.
Quellen
- OpenAI: Vorstellung von GPT-6 Sol und Luna (22. September 2026)
- OpenAI API: Changelog mit den Einführungsterminen
- OpenAI API: GPT-6 Astra
- OpenAI API: GPT-6 Sol
- OpenAI API: GPT-6 Luna