Kleine KI, schnelleres Sehen: Was Liquid AI mit DSpark ändert
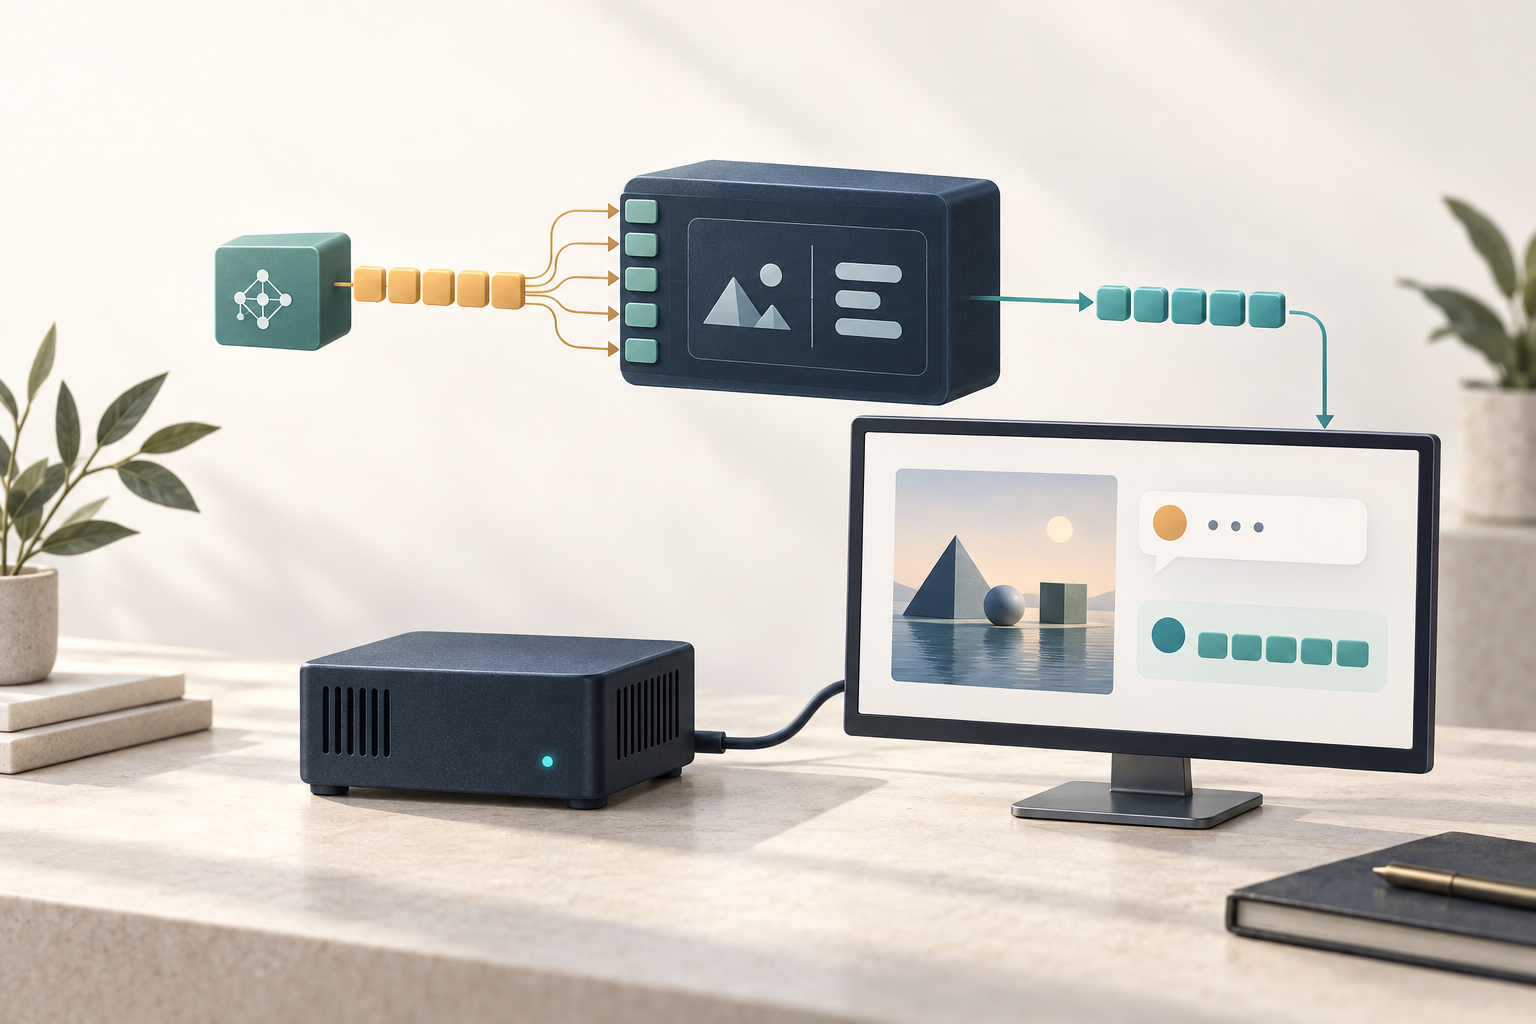
Ein KI-System soll ein Foto oder Diagramm analysieren, aber die Antwort kommt auf einem lokalen Gerät zu langsam? Liquid AI hat am 24. September 2026 einen experimentellen Baustein für sein Vision-Language-Modell LFM2.5-VL-3B vorgestellt: DSpark soll die Textausgabe beschleunigen, indem ein kleines Zusatzmodell mögliche nächste Tokens vorschlägt und das größere Modell diese parallel prüft. Das ist eine konkrete Modell- und Inferenz-Neuerung, keine allgemeine Automatisierungsankündigung. Für Unternehmen ist sie interessant, weil sie eine praktische Frage berührt: Kann visuelle KI schneller reagieren, ohne dass dafür ein größeres Zielmodell nötig wird?
Was Liquid AI tatsächlich veröffentlicht hat
In der datierten Originalankündigung vom 24. September beschreibt Liquid AI DSpark als experimentelles „draft model“ für LFM2.5-VL-3B. Es nutzt speculative decoding: Ein kleiner Entwurfsgenerator schlägt einen Block von Tokens vor, das Zielmodell überprüft ihn. Akzeptierte Vorschläge können gemeinsam verarbeitet werden, statt jeden Ausgabeschritt einzeln abzuwarten. Laut Liquid AI soll dieses Verfahren die Ausgabe beschleunigen, ohne die Ergebnisse zu verändern. Das ist eine Herstellerangabe, die für konkrete Aufgaben und Hardware unabhängig nachgemessen werden muss.
Der Zusatzdrafter umfasst laut Anbieter rund 280 Millionen Parameter, also 8,9 Prozent der drei Milliarden Parameter des Zielmodells. Die Ankündigung nennt bis zu 3,13-fache Decode-Geschwindigkeit auf einem M5-Max-Gerät und bis zu 2,66-fache auf einer H100-GPU. Bei der gesamten Laufzeit der getesteten Aufgaben fallen die angegebenen Gewinne kleiner aus: bis zu 2,62-fach beziehungsweise 2,27-fach. Liquid AI nennt sechs visuelle Aufgaben, darunter visuelle Frage-Antwort-Systeme, Texterkennung in Bildern, Bildbeschreibungen, Diagrammfragen und mehrstufige Dialoge. Diese Ergebnisse stammen aus Tests des Herstellers, nicht aus einem unabhängigen Vergleich.
Warum Decode-Geschwindigkeit nicht die ganze Antwortzeit ist
Der Unterschied zwischen Token-Tempo und Gesamtlaufzeit ist entscheidend. Eine Bild-KI muss zunächst das Bild verarbeiten und den Eingabekontext vorbereiten. DSpark beschleunigt laut Liquid AI nur die anschließende Ausgabephase. Wenn Bildkodierung und Vorbereitung einen großen Teil der Zeit beanspruchen, kann selbst eine deutlich schnellere Token-Erzeugung die Antwort insgesamt nur begrenzt beschleunigen.
Genau diese Einschränkung beschreibt auch Liquid AI: Bei Vision-Language-Modellen kommen zur Textverarbeitung Bildencoder und viele visuelle Tokens hinzu. Besonders auf Geräten mit begrenzter Rechenleistung kann die Vorverarbeitung einen relevanten Anteil beanspruchen. Unternehmen sollten daher nicht „bis zu 3,13-mal schneller“ als pauschale Antwortzeit verstehen. Die Kennzahl bezieht sich auf einen Teil der Verarbeitung und bestimmte Testbedingungen.
Wann das für Unternehmen relevant sein könnte
Der Ansatz ist vor allem dort prüfenswert, wo Bildverständnis und lokale Inferenz zusammenkommen: etwa beim Auslesen von Formularen, bei der visuellen Qualitätskontrolle, in der technischen Dokumentation oder bei der Analyse von Diagrammen. Eine niedrigere Verzögerung kann einen Arbeitsablauf angenehmer machen, wenn eine Person Rückfragen im Dialog stellt. Dass DSpark in Produktionsprozessen tatsächlich Zeit oder Kosten spart, belegt die Ankündigung allein jedoch nicht.
Die Unterstützung für llama.cpp, MLX-VLM und SGLang wird vom Anbieter als „day one“ angegeben. Das kann Teams mit bestehender lokaler Infrastruktur einen Test erleichtern. Es ist aber nicht gleichbedeutend mit einem einsatzfertigen Unternehmensprodukt: Modellkompatibilität, Versionen, Hardware, Lizenzbedingungen, Wartungsaufwand und Qualität der Ergebnisse müssen im eigenen Betrieb geprüft werden. Auch die Bezeichnung „experimentell“ sollte ernst genommen werden.
Ein belastbarer Test statt einer Benchmark-Übertragung
Ein sinnvoller Pilot beginnt mit einem klaren, wiederholbaren Datensatz aus dem tatsächlichen Prozess. Messen Sie mindestens drei Dinge getrennt: Zeit bis zum ersten Antwortzeichen, Zeit bis zur vollständigen Antwort und fachliche Qualität. Ergänzen Sie die Messung um Speicherbedarf und Auslastung, denn ein zusätzlicher Drafter kann für ein knapp dimensioniertes Endgerät relevant sein.
- Vergleichen Sie gleiche Bedingungen: dieselben Bilder, Prompts, Modellversionen und Hardware mit und ohne DSpark.
- Prüfen Sie die ganze Aufgabe: nicht nur Token pro Sekunde, sondern auch Bildvorverarbeitung und vollständige Antwortzeit.
- Bewerten Sie Fehler: kontrollieren Sie Extraktionen und Antworten gegen eine Referenz, insbesondere bei kleinen Schriftarten, ungewöhnlichen Layouts und mehrdeutigen Bildern.
- Testen Sie den Betrieb: prüfen Sie RAM, Energieverbrauch, Startzeit, Parallelbetrieb und Verhalten bei langen oder fehlerhaften Eingaben.
- Dokumentieren Sie Grenzen: halten Sie fest, für welche Fälle das System nicht zuverlässig genug ist und wann eine menschliche Prüfung erforderlich bleibt.
Was offenbleibt
Die veröffentlichten Zahlen sind interessant, beantworten aber nicht automatisch, wie stark ein Unternehmen profitiert. Die Ergebnisse hängen von Hardware, Eingabematerial, Modellversion und Anteil der Ausgabephase an der Gesamtlaufzeit ab. Auch die Übertragbarkeit auf eigene Daten und die langfristige Stabilität des experimentellen Bausteins sind aus einer Ankündigung nicht abzuleiten. Vor einer Einführung gehören deshalb ein eigener Benchmark, eine Lizenzprüfung und ein klarer Rückfallweg zum Vorhaben.
Für sensible Bilder kommt eine weitere Ebene hinzu: Lokal ausführbare Modelle können helfen, Datenflüsse anders zu gestalten, garantieren aber nicht von selbst Datenschutz oder sichere Verarbeitung. Entscheidend sind konkrete Speicherorte, Protokollierung, Zugriffsrechte und der Umgang mit Eingaben und Ausgaben. Diese Punkte sollten getrennt von der reinen Geschwindigkeitsfrage bewertet werden.
Fazit: ein interessanter Beschleuniger, kein pauschales Leistungsversprechen
LFM2.5-VL-DSpark ist ein neuer experimenteller Weg, die Ausgabe eines visuellen KI-Modells durch speculative decoding zu beschleunigen. Die von Liquid AI genannten Messwerte sind beachtlich, beziehen sich aber auf definierte Tests und zeigen selbst einen Abstand zwischen Decode-Tempo und Gesamtlaufzeit. Für Unternehmen lautet die praktische Konsequenz: erst die eigene Aufgabe messen, dann über Rollout sprechen. Ein kleiner, kontrollierter Versuch kann zeigen, ob schnellere Antworten den Prozess wirklich verbessern, ohne Qualität, Ressourcenbedarf oder Datenschutz aus dem Blick zu verlieren.
Wenn Sie KI-Anwendungsfälle im Unternehmen strukturiert bewerten möchten, finden Sie Informationen zu unserer KI-Beratung und zu KI-Schulungen.
Hinweis: Dieses Titelbild wurde mit Hilfe von Künstlicher Intelligenz erstellt.
Quellen
- Liquid AI: LFM2.5-VL-DSpark: Accelerating vision-language models on edge and beyond, 24. September 2026.
- Liquid AI auf Hugging Face: Accelerating vision-language models with LFM2.5-VL-DSpark, 24. September 2026.
- Liquid AI: LFM2.5-VL-3B-DSpark Modellkarte.